
部署体验
git clone https://github.com/deepseek-ai/DeepSeek-OCR.git && cd DeepSeek-OCR

conda create -n ocr python=3.12
conda install cuda-toolkit=12.8

pip install torch==2.8.0 torchvision==0.23.0 torchaudio==2.8.0 --index-url https://download.pytorch.org/whl/cu128
pip install -r requirement.py

python DeepSeek-OCR-master/DeepSeek-OCR-hf/run_dpsk_ocr.py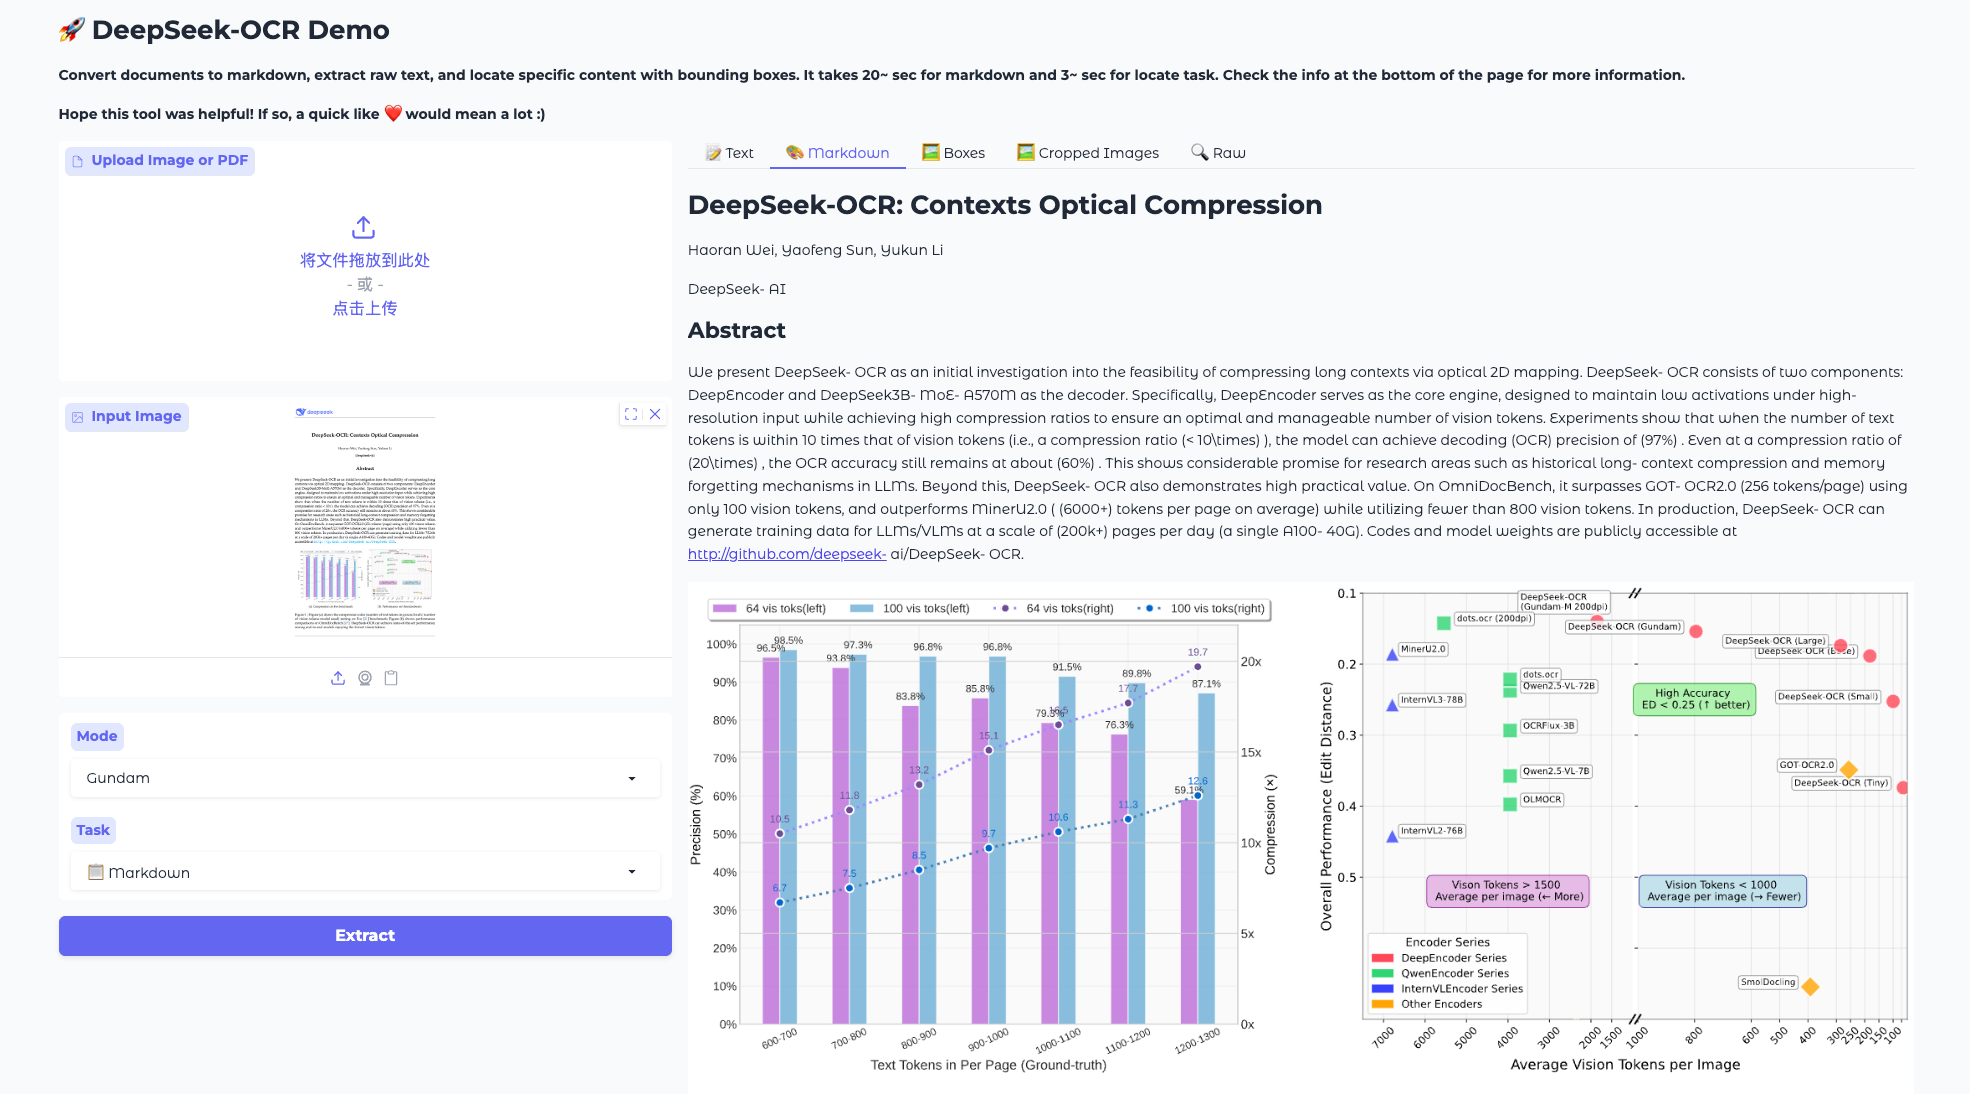
模型架构
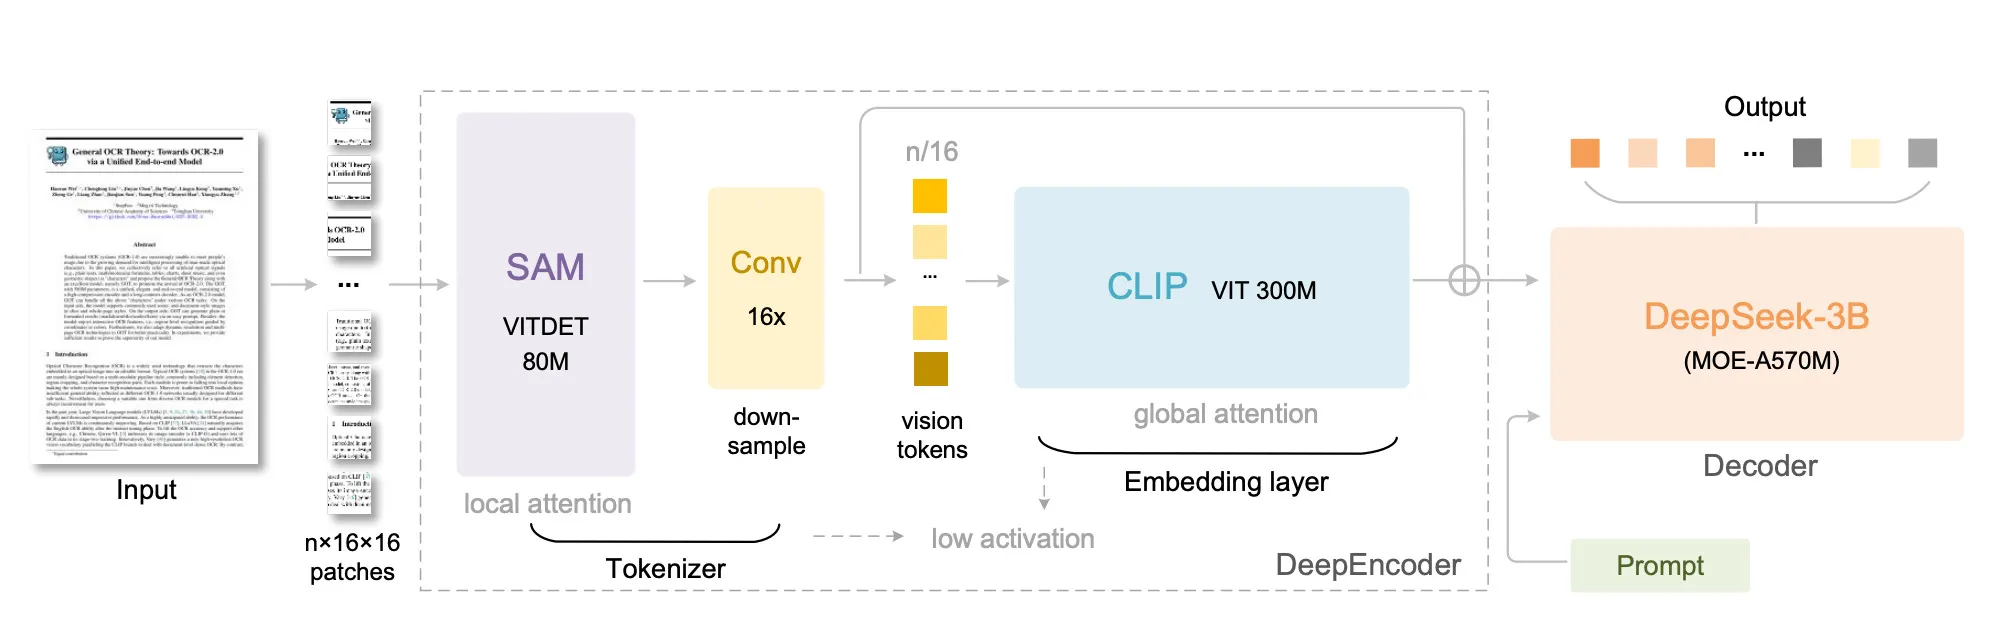
-
将输入的图片进行切分,得到 n 个 16x16 patches 图片块
-
使用 SAM 模型获取局部的 attention,并采用 16x 的下采样将 vision token 压缩到 n/16 个
-
将 vision token 逐个输入到 CLIP 模型,得到图片块的 Embedding
-
将图片块的 Embedding 和 Prompt 对应的 Embedding 合并作为输入,喂给 DeepSeek-3B
-
DeepSeek-3B 根据输入语义,完成实际的任务
Q&A 自问自答
Q1. DeepSeek-3B 作为 backbone 时参数是否冻结?
Q2. SAM/CLIP/DeepSeek-3B 间的维度如何对齐?
-
在 SAM ⇒ CLIP 中间有一个 16x 的卷积层,可以特征向量缩放到 1024。这与 CLIP 模型的特征向量维度一致。
-
在 CLIP ⇒ DeepSeek-3B 中间有一个投影层,会将特征向量维度缩放到 1280。值得注意的是,在投影层前会将 SAM 输出的 1024 维特征向量与 CLIP 输出的 1024 维特征向量进行拼接,然后再进行投影。
n_embed = 1280  # 目标输出维度
self.projector = MlpProjector(Dict(
    projector_type="linear",
    input_dim=2048,      # 输入维度: CLIP + SAM = 2048
    n_embed=n_embed      # 输出维度: 1280
))
Q3. Vision token 和 Prompt 如何作为 DeepSeek-3B 的 input?
几点畅想
-
在论文中提到虽然训练数据集中包含了 100+ 种语言,但绝大多数还是中英文的资料。因此,在 DeepSeek OCR 基础上对不同的语言进行调优应该是有可能的。例如,藏文、梵文等。
-
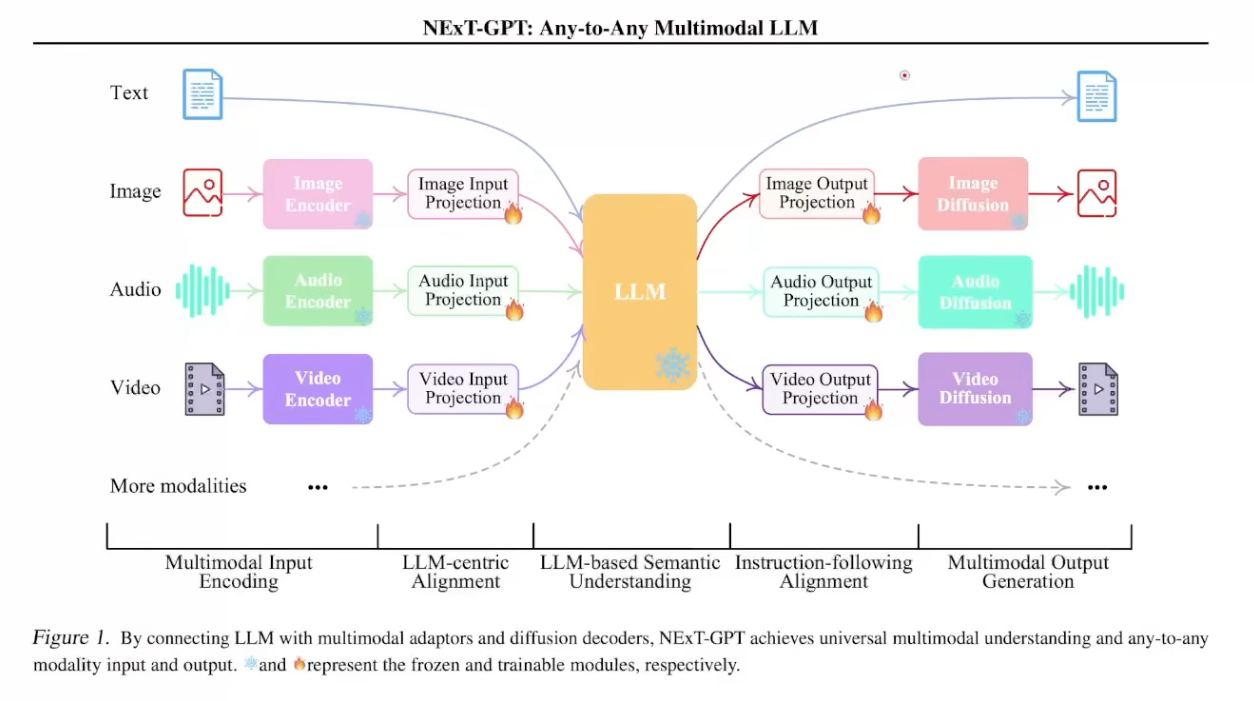
OCR 和 LLM 结合,通过自然语言来驱动 OCR 处理任务,可以发挥 LLM 的泛化能力,为处理复杂任务提供了更多的可能性。
-
DeepSeek OCR 模型参数较少,在端侧也会有一些场景
-
关于利用 Vision Token 来压缩 LLM 对话上下文长度,是一个很有意思的想法。是否会出现通用的 DeepEncoder 可以嫁接在任意 LLM 前面来处理信息压缩后的图片?