
背景
-
在 VSCode 中让 Github Copilot 进行辅助阅读源码,针对不明白的点,及时提问
-
等所有细节都整理清楚后,将与 Copilot 的聊天内容导入到 NotebookLM 中
-
在 NotebookLM 中,再次对内容进行梳理,NotebookLM 也会主动引导提问
-
对 NotebookLM 每轮返回的结果进行评估,如果符合预期则保存为 note
-
在 NotebookLM 中,将所有保存的 note 作为 source,然后通过「Slide Deck」生成 Slide
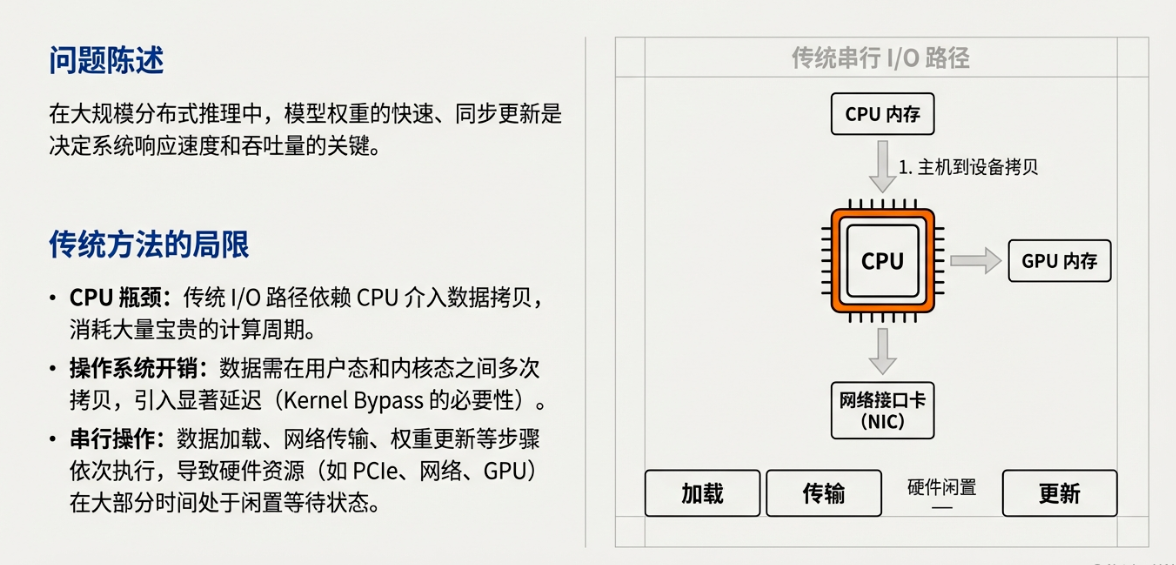
核⼼挑战:⼤模型时代下的权重更新瓶颈
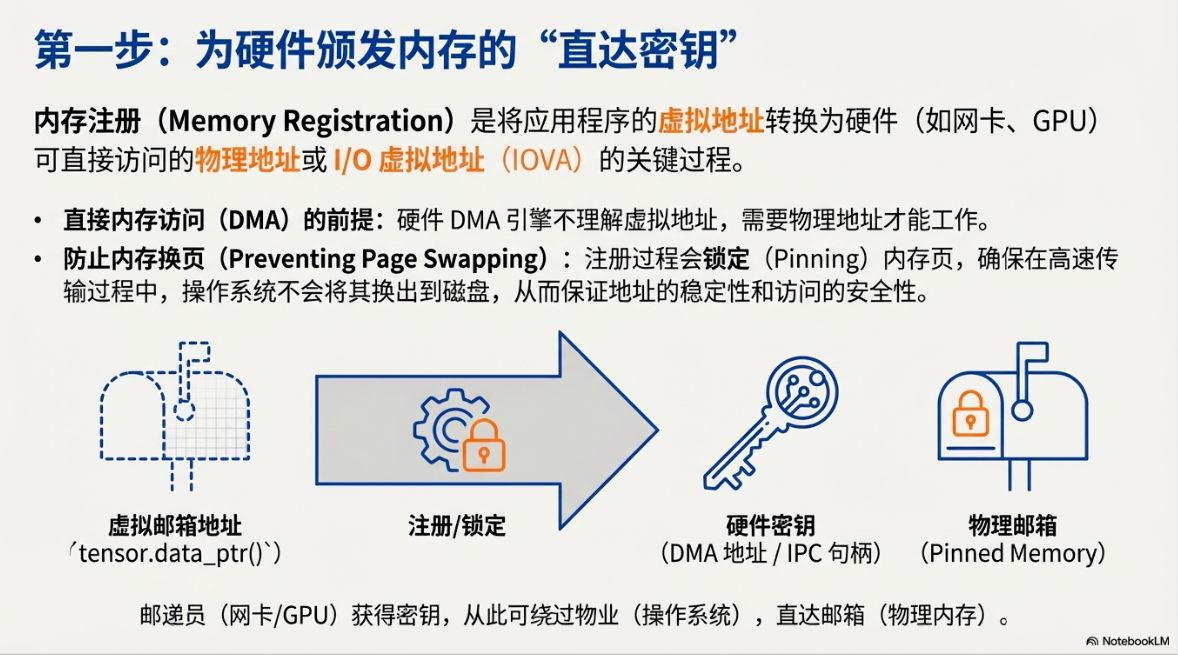
优化一:提供硬件直达,消除中介
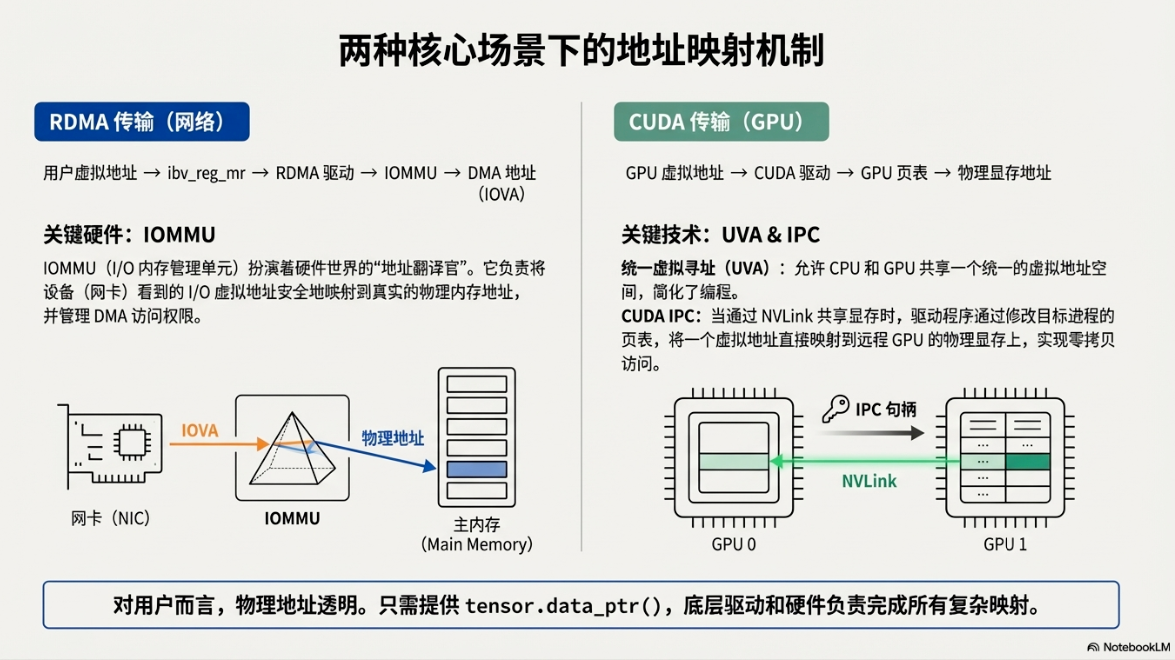
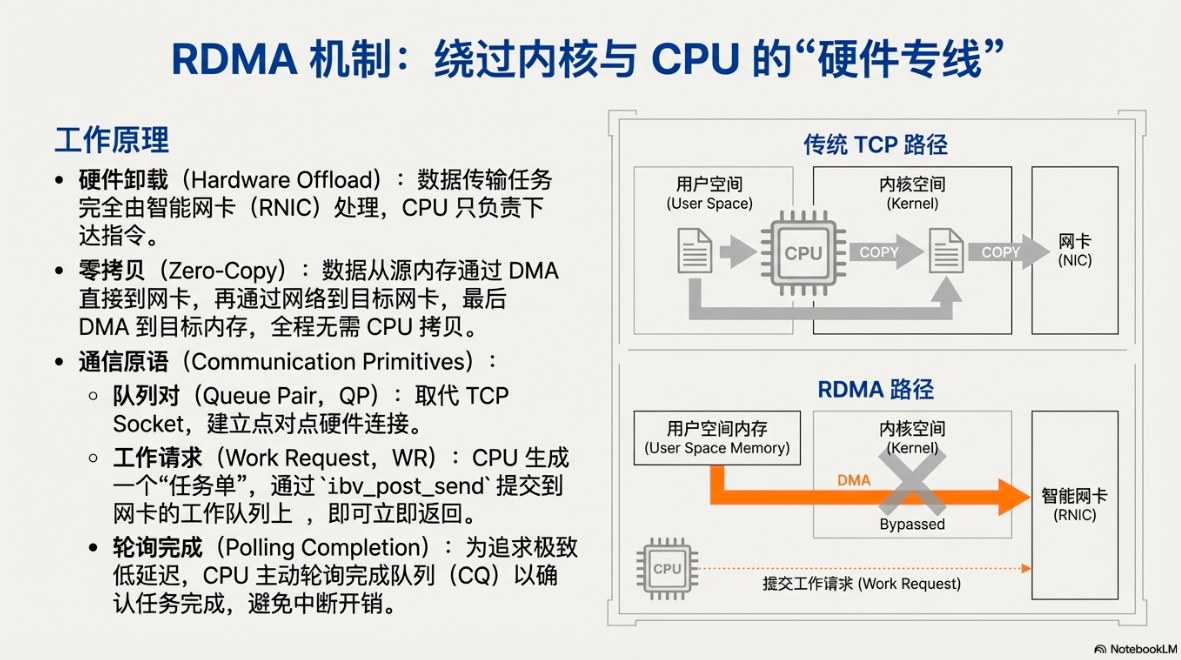
优化二:零拷贝与内核旁路,告别开销
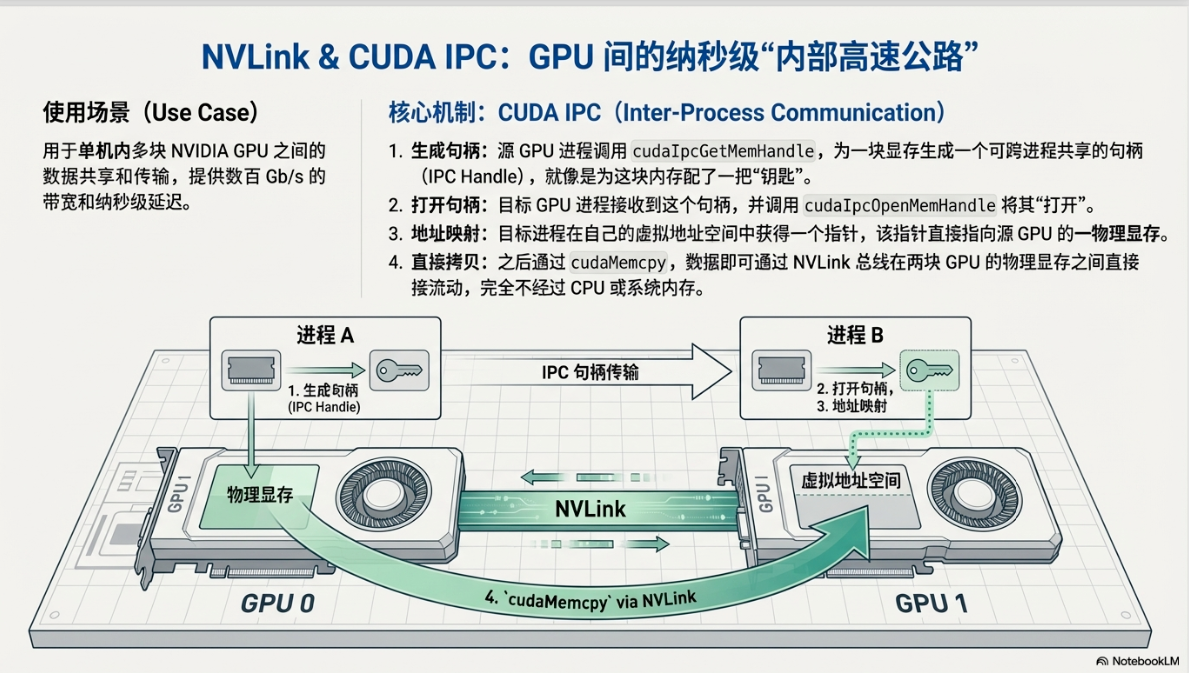
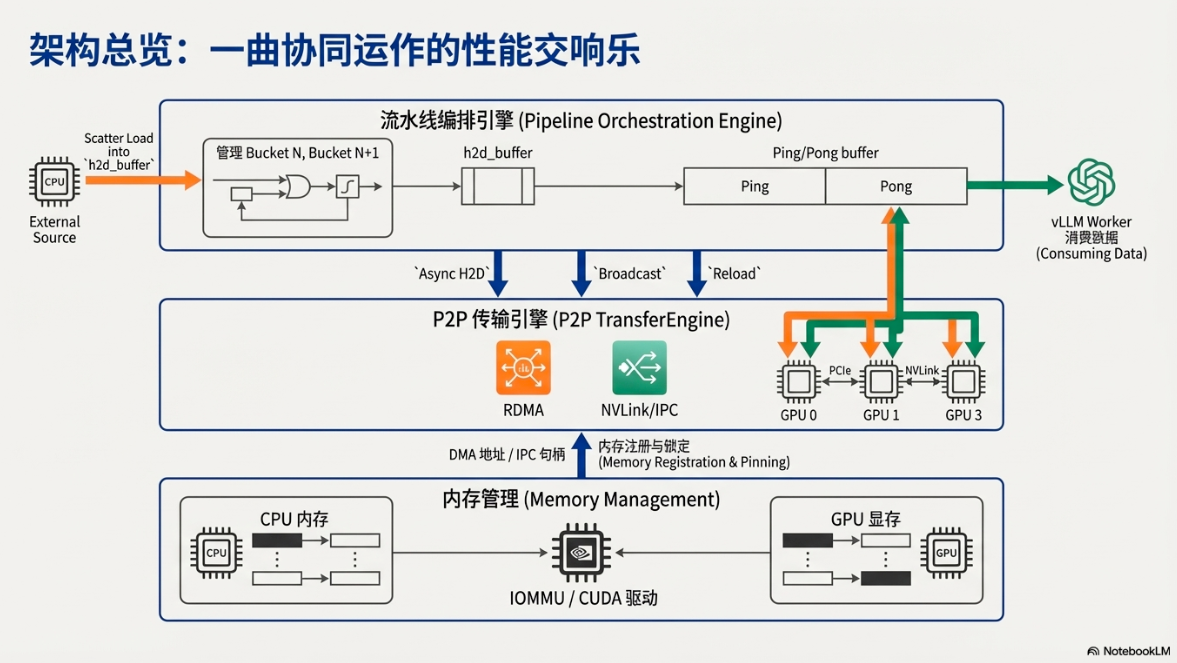
优化三:利用 P2P 以及流水异步化机制,压榨并行
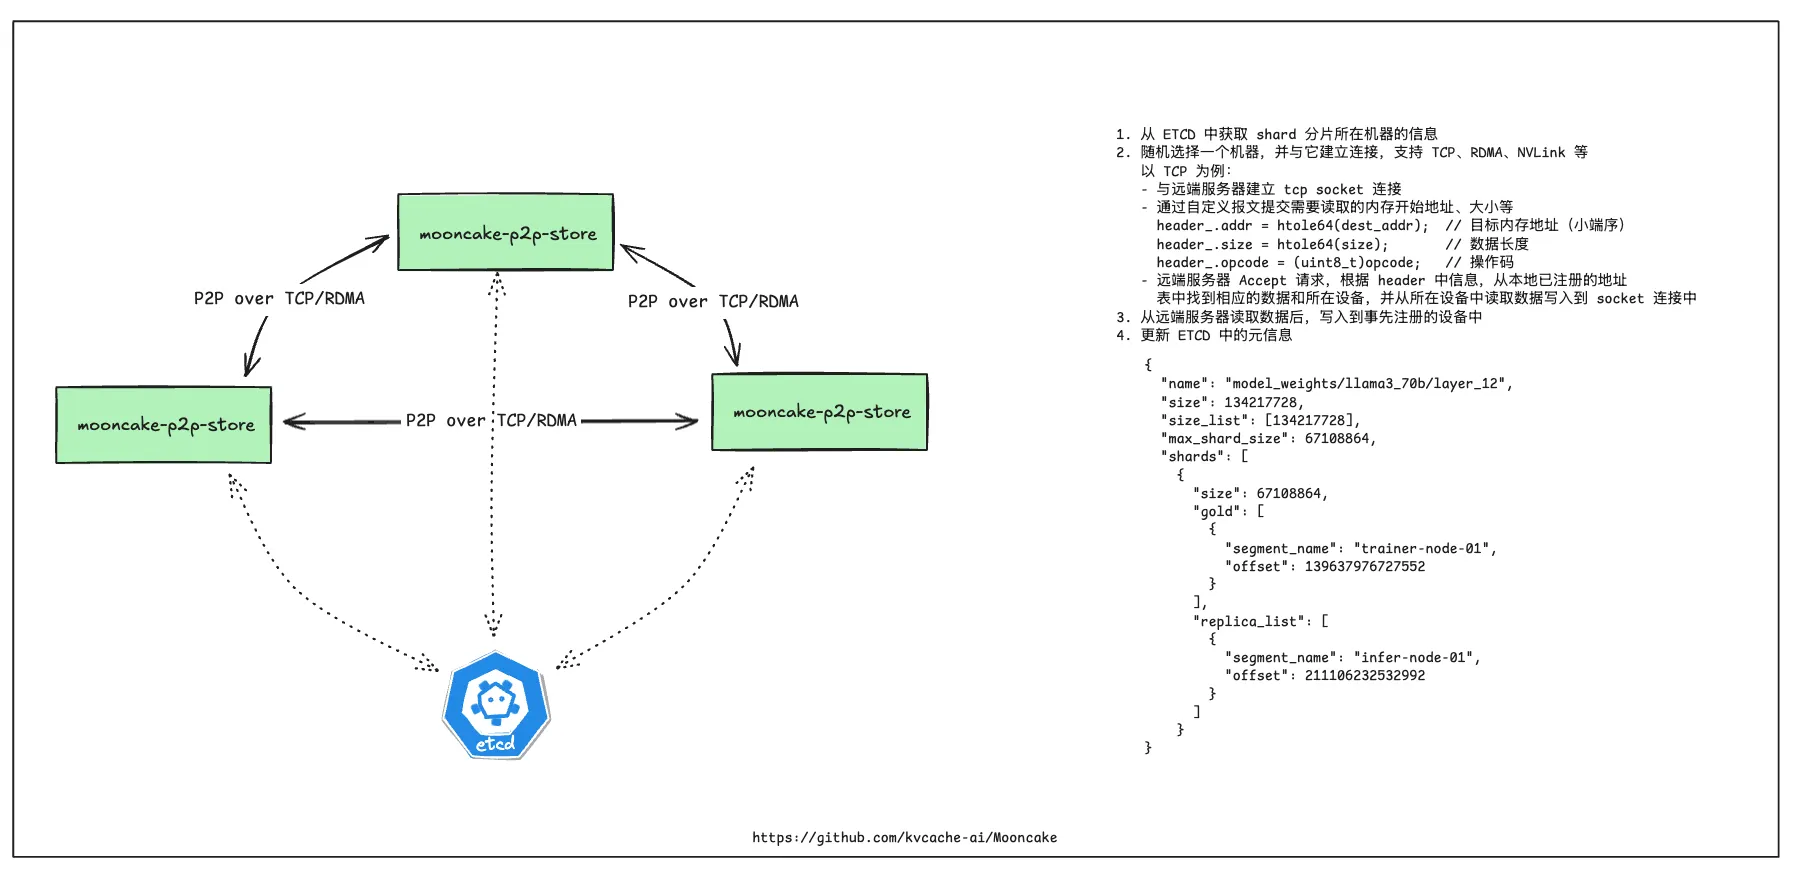
这里需要补充一点,在 checkpoint-engine 中 P2P 只在 h2d 阶段获取原始权重时才会用到,其余权重同步逻辑均由 NCCL 库来实现。
单 GPU 视角
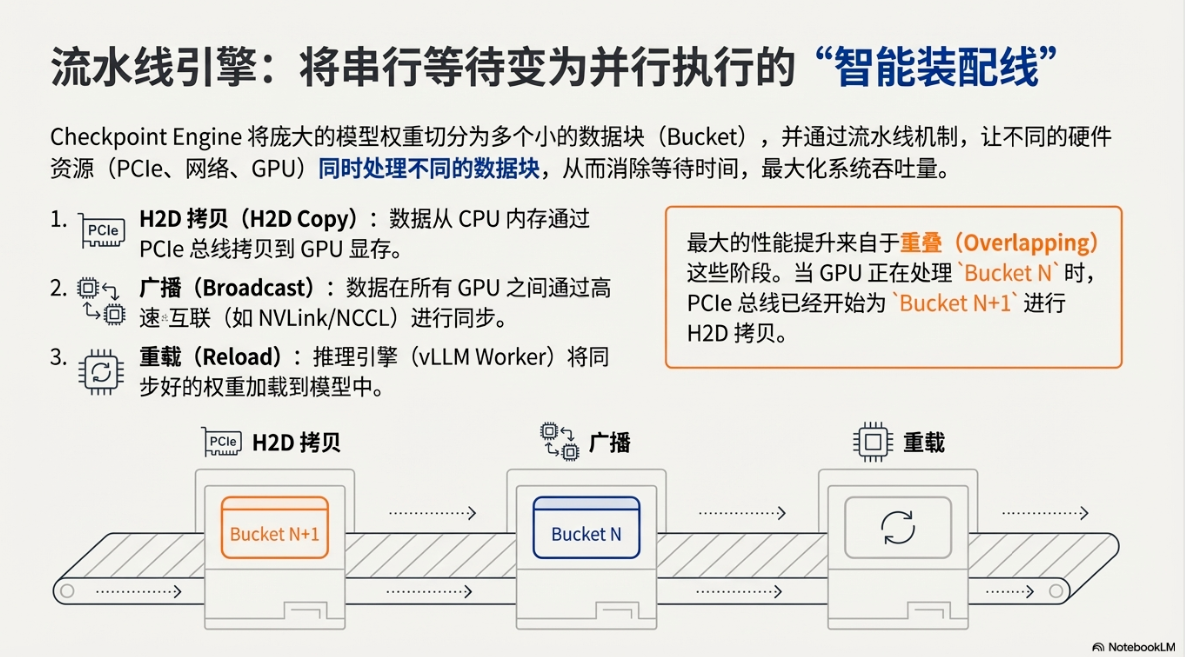
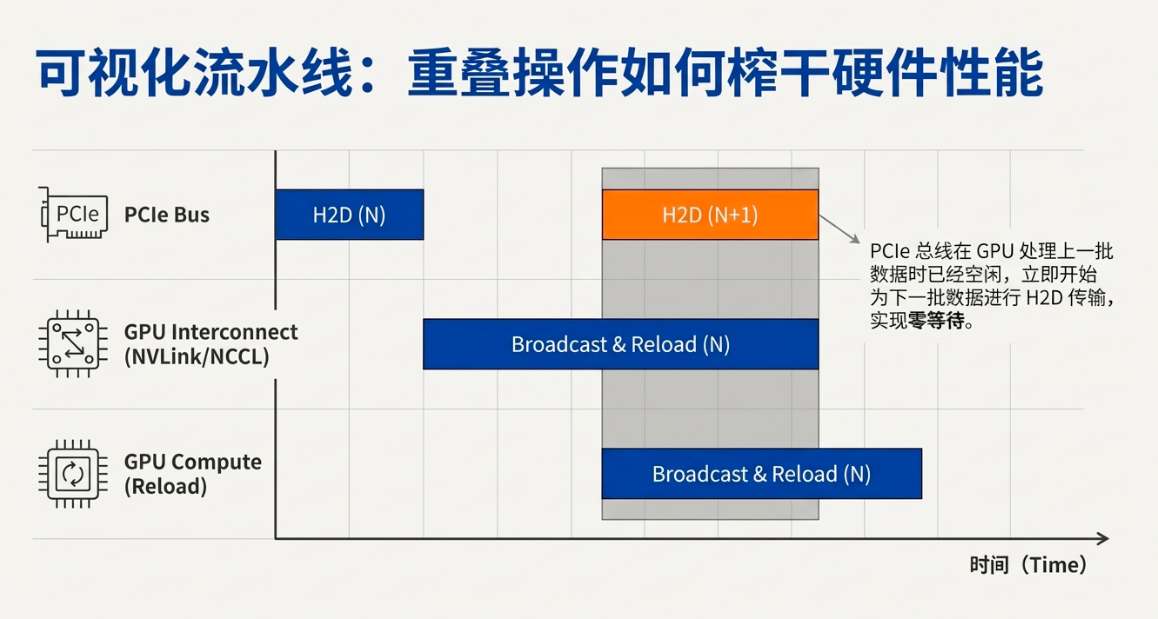
多 GPU 视角
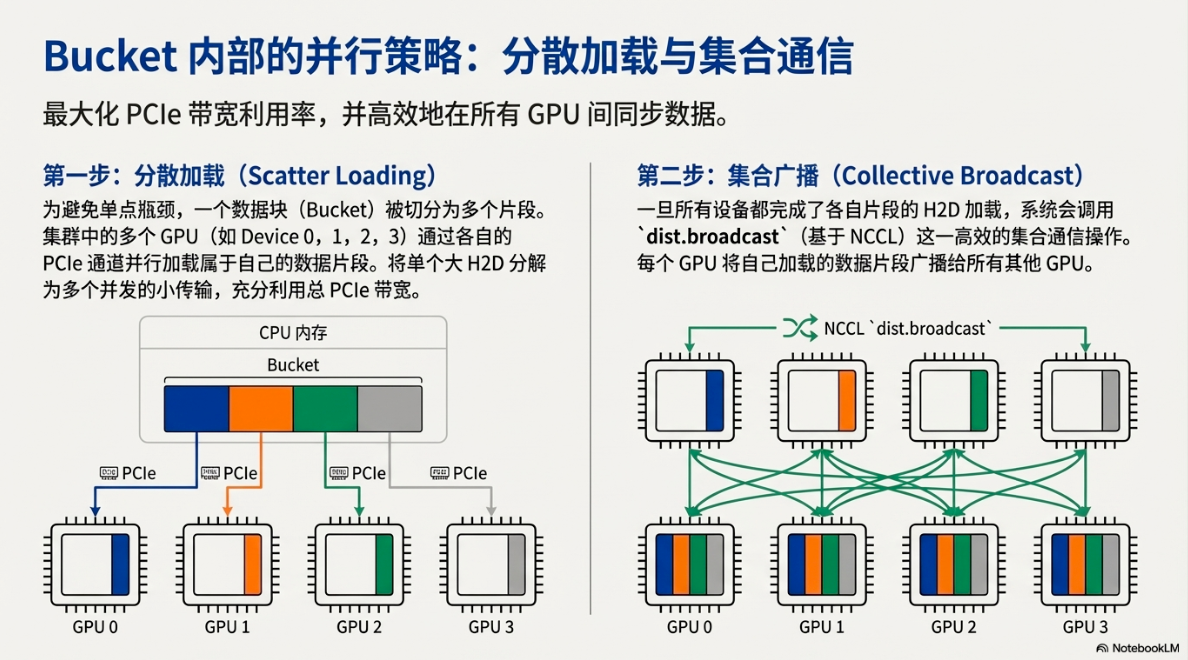
总体架构回顾
P2P 分发 & vLLM 更新权重
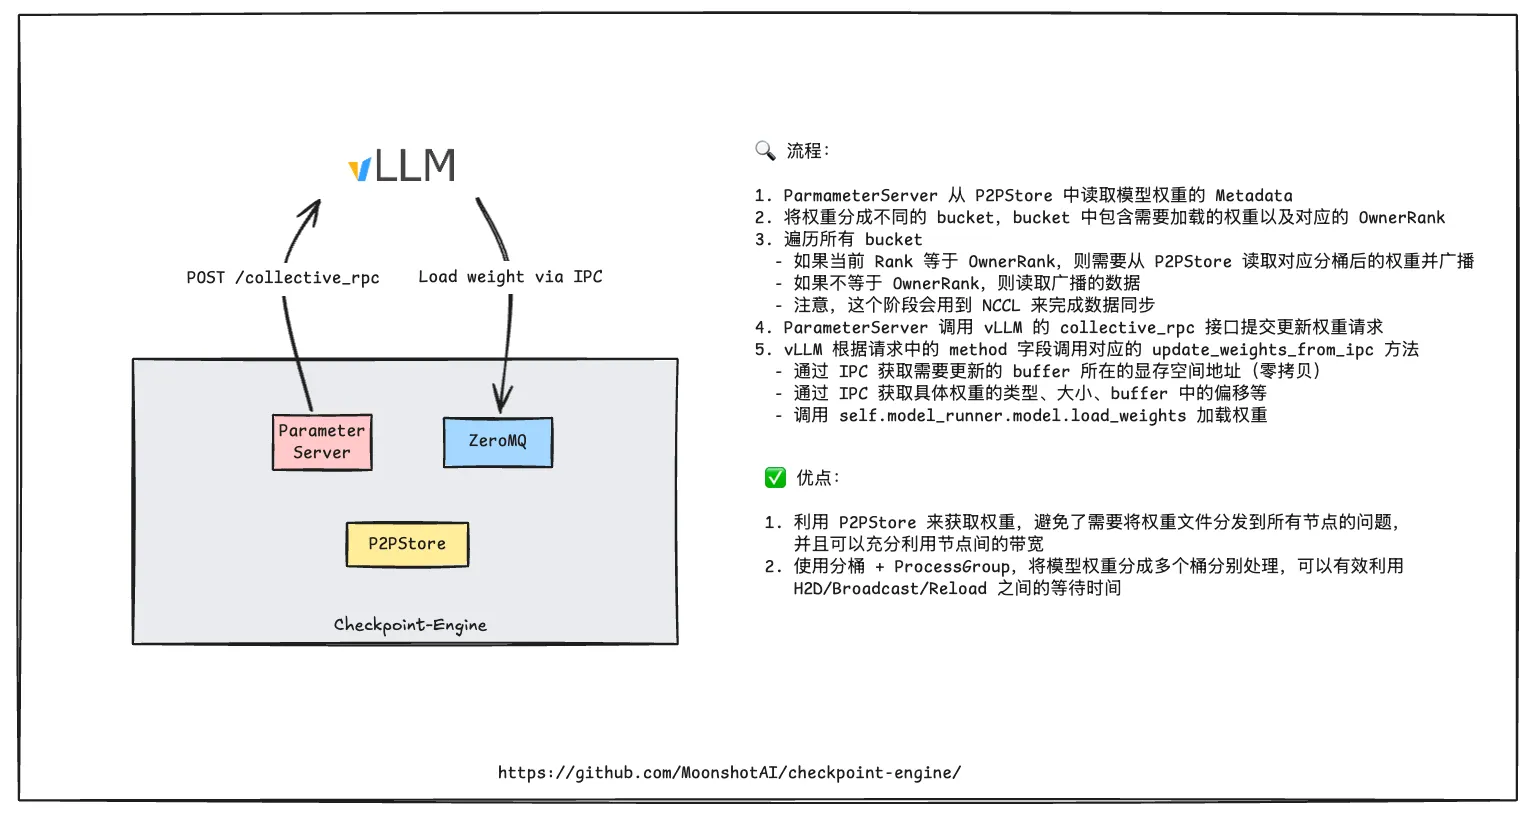
总结 & 思考
-
权重按 bucket 细分后,可以充分利用 PCIE、RDMA 性能,减少硬件闲置
-
巧妙的利用 Ping/Pong buffer 来实现读写分离,保证高效并行
-
直接使用 NCCL 库来做同步,而不是 TransferEngine 的 P2P 来做,蛮可惜的,无法确定 TransferEngine P2P 的性能
-
NCCL 同步需要保证所有 GPU 都完成操作,一旦有一个没有完成,则所有进程均会卡住